第三十六期
2026-10-11
本期主要介紹Meta全新推出的AI助理Muse,以及AI「IBM Watson」的興衰與新模型「Jev」的崛起與野心,還有程式貓和海洋大學共同舉辦的黑客松競賽,
一.新的AI助手? 全新AI Muse帶你看
作者:Lhs
前一陣子,Meta趁著最近的AI助手熱潮,推出屬於自己的AI助手:
Muse AI
於美國展開測試。並在網路上掀起一陣熱潮,也已經有許多人開始實際使用並把測試影片傳出,就讓我們一起來看看這款新的AI助手表現如何吧!
一.可愛活潑的風格
從官方的展示片段,以及其他人的實測畫面可以看到,Meta嘗試將Muse塑造成一個可愛活婆的吉祥物,並且在和你對話的時候,還會出現在聊天室的頂端,打破了以往使用AI工具時,只能跟一個「冰冷冷的對話框」對話的印象。
在跟你對話的時候,他還會跟呆萌的搖頭晃腦,是個十分可愛的畫面
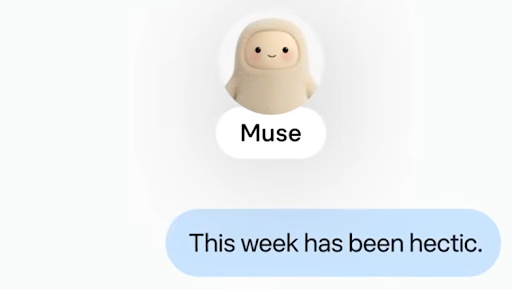
出現在聊天室頂端的Muse本尊 圖片取自官方宣傳片
二.在背後幫助你的私人秘書
在網路上Youtuber們的使用中,Muse AI可以做到讀取你的Meta旗下帳號,做到像是尋找許久沒連繫的好友、組織一次聚餐、甚至是跟電話客服對話等行為,還能透過你的喜好,推薦你所在位置附近的店家,並且由於Meta帳戶的服務範圍廣闊,在處裡不同服務時,若遇到帳戶登入問題也能更快解決。
再來看到使用額度上,Muse每週提供將近1億個Token免費使用,雖然有額外提供付費方案,但正常使用上應該是不會有需求,換句話說,我們可以在不付費的情況下獲得一個萬能AI助手。
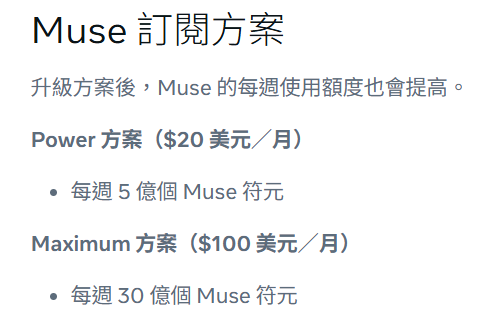
Muse的付費方案,圖片取自官網
單看功能方面,Muse AI可以說是十分成功的AI助手,但在功能萬全的背後,我們也不得不思考以個老問題:
使用者該如何保護自己的資訊安全?
三.Muse的資安是否可以信任?
祖克柏在發表時表示,Muse的賣點是「不只幫你省錢,甚至還能幫你賺錢」,並且,他們也將商業模式訂為「在使用者使用商業服務時抽取服務費用」而非傳統的月費制度,由此可見,Meta對它的商業服務是非常有自信的,但是,使用者是否能安心地把各資交給Muse呢?
實際上,Meta為了解決資安問題,特定為其設計了一套防護系統,主要為以下四點:
-
雲端專屬虛擬機與獨立監控:透過獨立的雲端虛擬機,將Muse的權限牢牢把握,無法連接未經允許的連線
-
帳密與支付安全 :在使用金融服務時,Muse所看到的是獨立的「替身憑證」,這麼一來,Muse就無法讀取你的真實個資並完成服務
-
資料自主權與廣告隱私:在進行寄信、交易的行為時,都需要使用者本人的同意的允許才可進行,以避免發生未經允許的行為,並且使用者也可強行讓Muse移除重要資訊,避免個資外洩
-
人類掌控與防禦強化:在Meta的設想中,未來的服務將會完全在使用者和雲端虛擬機之間,獨立的端對端進行,屆時甚至連Meta公司都無法存取服務紀錄,做到絕對的資料防護
並且,Meta公司還祭出30萬懸賞,邀請全球駭客攻擊自家防禦系統,以此抓到防禦弱點和補強。
目前Muse只在美國地區開放使用,台灣則可以開始申請候補志願者,想問問各位讀者,如果是你們會想要試試看這個專屬於你的AI助手嗎?又是否願意將個資交給Muse來幫你服務呢?
資料來源:
https://www.youtube.com/watch?v=MpiAqsEgWDo
https://about.fb.com/news/2026/09/introducing-muse-personal-ai-agent/
https://www.youtube.com/watch?v=Ol82S1UVt7E
二.初出茅廬的 Jev 與他的大前輩 IBM Watson – 從 IBM Watson 的興衰,看 Jev 的信心與野心
作者:KH
引言:那曾經被認為會改變世界的人工智慧
2011 年 2 月,IBM 的 Watson 在美國益智節目 Jeopardy! 擊敗 Ken Jennings 與 Brad Rutter 兩位傳奇衛冕王。Jennings 在最後一題的答案旁,半開玩笑地寫下歡迎新的電腦霸主。那一刻,許多人真心相信:電腦讀懂人類語言的時代來了!
接下來幾年,這份信念持續升溫。IBM 宣告「認知時代」來臨,Watson 被描繪成能讀遍醫學文獻、協助醫師戰勝癌症的系統;從醫療、金融到零售,彷彿沒有它改變不了的產業。
回頭看,那場比賽最值得記住的其實不是勝利,而是畫面上特定為 Watson 顯示的各選項的信心值。每道題目結束後,節目都會秀出 Watson 心中排名前三的候選答案與各自的信心值。信心超過九成時它果斷搶答;三個答案都只有一兩成時,它就會默默地讓人類先答。
十五年後的 2026 年 9 月,舊金山新創 TypeSafe AI 推出 Jev。它不像傳統的 LLM:你丟給它一個問題和一組選項,它只回傳一個選擇,外加一串機率。還記得 IBM Watson 當年那場比賽的人,或許會聯想到那排似曾相識的信心值,也很難不想起隨之而來的那場集體期待。
那 Jev 是 Watson 的精簡版轉世嗎?本文的答案是:這個類比有一半正確;但在故事怎麼被描寫、熱潮如何形成、風險藏在哪裡這幾點上,兩者相似得令人不安。
相似處一:實用性在於它有多少把握
Watson 和 Jev 賣的都不只是答案,而是「這個答案有多可信」。兩者也都把「這個數字如何利用」交給另一層邏輯去決定。
Watson 背後的 DeepQA,核心不是某個新演算法,而是同時跑上百種既有的語言分析方法,再把各路證據分數合成一個信心值。越多獨立方法指向同一答案,信心就越高。按不按鈴,則由信心值與門檻比較決定;IBM 研究員 Jon Lenchner 當時說明,預設門檻約為 50%,並會隨賽局狀態浮動。
最能說明這套邏輯的是在比賽第二晚的 Final Jeopardy。題目類別是美國城市,Watson 卻答了加拿大的 Toronto,錯得離譜,但它只押了 947 美元。它知道自己沒把握,並把這份沒把握轉成了停損。
TypeSafe 在官網發布 Jev 的文章,幾乎是同一個論證的現代版。創辦人 Diogo Almeida 寫道:一個模型就算 95% 的時候都做得對,只要它不告訴你哪些時候落在那 5%,這個任務就無法自動化。所以 Jev 的每個輸出都附帶校準過的機率,訓練目標也從「讓人類喜歡」改成「機率要誠實」,他們稱之為 RLCD。
接下來的分工也和 Watson 如出一轍:模型只負責給出判斷與信心值,「要不要照著做」則交給另一層規則把關。以客服系統為例,Jev 判斷一張工單「是退款申請,把握 0.92」,接著由工程師寫好的程式碼接手:把握超過 0.9 就自動處理,否則轉給真人。TypeSafe 把這種用法稱為「聰明的 if 判斷式」。Watson 也是同樣的結構:算出信心值後,由事先設計好的搶答門檻與下注策略,決定要不要按鈴、押多少錢。
差別在於誰來寫這個 if。IBM 的團隊花了近四年、動用約二十位研究員專為 Jeopardy! 打造節目上使用的 Watson,搶答門檻與下注策略還有專人以模擬反覆調校;Jev 則把這件事交給每一位開發者。Earendil 技術長 Armin Ronacher 對 TechCrunch 的評論很貼切:這個模型在某種程度上,是把幻覺問題轉交給使用者,由他們自己決定機率多高才算可信。
相似處二:使用合成資料,與「誰的判斷」當標準答案
兩者都在「人造的世界」裡接受訓練或驗證,也都把某一小群參照者的判斷當成標準答案。這是兩者最底層、也最容易被忽略的相似處。
Watson 轉戰醫療後,最受矚目的產品是與紐約 Memorial Sloan Kettering(MSK)癌症中心合作的 Watson for Oncology。2018 年,STAT News 取得 IBM 內部簡報:客戶與內部醫療專家發現多起不安全、不正確的治療建議,主因是系統只用少量「合成」的假設病例訓練,而非真實病患資料。
更關鍵的是標準答案的來源。內部文件指出,建議依據的是每種癌症一兩位專科醫師的經驗,而不是診療指引或實證。外界以為自己拿到的是「AI 分析大量病例」的結果,實際上更接近「幾位 MSK 醫師的偏好」。
對此,MSK 回應:那些錯誤建議出現在系統測試階段,並未用在真實病人身上;合成病例反而能涵蓋更多元的治療選項。合成資料本身確實不是問題;真正的問題在於這些病例由誰設計,標準答案又代表誰的判斷。
Jev 也站在類似的基礎上。根據 TechCrunch 的報導,TypeSafe 表示 Jev 完全以合成資料訓練;但這些資料由誰、以什麼方式生成,公開資訊裡看不到細節。
它的「標準答案」問題在官網的發布文章裡也有提到。TypeSafe 的工作流程評測,是拿 GPT-6 Astra 與 Claude Fable 5.1 兩個前沿模型的平均預測當參考答案,而不是真實世界的結果;評測流程本身也是自家能力團隊成員設計的。TypeSafe 團隊也表示這可能帶有偏差。
換句話說,以官方評測而言,「Jev 很準」的意思其實更接近「Jev 的判斷很像兩個頂尖 LLM 的共識」。那當然還是有參考價值,但它能不能等同於「在你的業務範圍內判斷正確」,仍有與過去 Watson for Oncology 類似的疑慮。
相似處三:舞台效應,從 Jeopardy! 到 Doom
兩者都靠一場精心挑選的公開展示打響名號;展示證明的能力是真的,卻往往不是市場後來要它們解決的那個問題。
Jeopardy! 對電腦其實很友善:每道題都有唯一的標準答案,有裁判判定對錯,Watson 還以文字形式直接收到題目。它的弱點反而是聽不到對手的回答,曾重複人類剛答錯的答案。
真正的考驗在節目之外。MD Anderson 癌症中心從 2012 年起與 IBM 合作開發腫瘤專家系統 Oncology Expert Advisor,IBM 在 2013 年的新聞稿中把它包裝成消滅癌症任務的一部分。到 2017 年德州大學系統的稽核報告公開時,專案已花掉超過 6,200 萬美元,約 3,900 萬付給 IBM、約 2,100 萬付給 PwC,系統卻仍未進入臨床使用。
IBM 的回應反而最能說明問題。它強調,連稽核報告都承認 Watson 在肺癌治療建議上有 90% 的準確率。但這個漂亮的數字沒能救回專案。
真正拖垮它的,是兩件和準確率無關的事:專案目標一再更改、範圍不斷擴大;醫院後來換了新的電子病歷系統,這套腫瘤專家系統卻沒有跟著整合,也就無從進入臨床使用。換句話說,準確率是在測試環境裡量出來的,專案卻是在落地整合時失敗的。
回到現在,Jev 的舞台是 Doom。TypeSafe 展示由 Jev 即時操控這款經典射擊遊戲,每秒約 10 次查詢,每小時成本約 7 美元。官網的發布文章描述道「 Jev 讀到的是文字化的遊戲狀態,不是畫面」以及「一個不用 AI 的 Doom 機器人其實可以玩得更好」。
有趣的是,兩個舞台都把世界先轉成乾淨的文字再送進模型。Doom 證明了速度與成本,就像 Jeopardy! 證明了封閉世界的問答。對 Jev 來說,真正的考驗不會是下一個遊戲展示,而是像 Watson 當年那樣的落地現場:例如每天湧進企業信箱的郵件,中英夾雜、格式五花八門,寄件者還會不斷換招嘗試騙過過濾器。能不能在這種環境裡依然判斷準確、信心值依然可信,才是它真正要證明的事。
「新類別」的說法,經得起拆解嗎?
Jev 的說法相當宏大:「一種新類別的前沿模型」、新架構、新的並行取樣器、新的訓練法 RLCD。
但 TypeSafe 沒有發表 RLCD 論文,也未公開基礎模型或參數量。TypeSafe 表示 Jev 以 transformer 為基礎,但不是 LLM;不過根據 TechCrunch 報導,外部觀察者懷疑底層可能是一個現成的開放權重模型。
在同一時間,社群的反應也很迅速。發表不到兩週,Hugging Face 上就出現多個自稱「開源重現」的模型。其中一個專案表示,用 Jev 的輸出在一個 9B 的 Qwen 模型上蒸餾約 3 個 GPU 小時,就能近乎複製它的輸出分佈;另一個專案在自建的 200 題通用決策測試上,量到 Jev 準確率 0.730、校準誤差(ECE)0.164,落後 Fable 5.1 與 GPT-6 Astra。
這些都是開發者自行公佈、未經同儕審查的數字,不宜當成定論。但它們一起指向一個問題:如果這個「新類別」模型的行為能在幾個小時內被幾乎複製,開發者為何還要選擇 Jev?
但這次有幾件事真的不一樣
歸納來說,Jev 比 Watson 穩健的地方有四個:承諾更窄、試錯更便宜、對自己的侷限更透明,而且外界檢驗得更快。
承諾更窄。 Watson 的承諾是改變醫療、消滅癌症;Jev 的承諾是在開發者事先定義的選項裡挑一個,並輸出信心值有多少。由於答案只能從給定選項中挑選,它不會回傳格式錯誤的內容,也不會憑空捏造選項,這是設計上的保證。承諾越窄,越有機會兌現。
試錯更便宜。 Watson 當年的癌症合作計劃,花了四年多、數千萬美元才發現行不通。Jev 則是按 token 計費的 API,已上架 Vercel 與 Cloudflare,也有 LangChain 等整合。一個工程師一個下午就能拿自己的資料測試,不適合就放棄;錯誤會在幾週內浮現,而不是幾年。
對自身侷限更透明。 TypeSafe 官網的發布文章在每個主張後面附上「細節」註腳:評測流程由自家團隊設計、參考答案偏向特定廠商、193.6 倍加速是最理想情況(實際多半沒那麼多)、幻覺率為零並非實測而是由結構保證。文中甚至直言歡迎外界質疑,還說他們自己也是懷疑論者。對照 2018 年 IBM 高層仍公開稱 Watson 進展「好極了」,而內部簡報早在前一年就記錄了錯誤建議,兩種姿態差很多。
外界檢驗得更快。 早期客戶已公開測試數據,連 Jev 表現不如對手的地方也如實寫出。據 TechCrunch,Vercel 用 Jev 取代原本的指令安全檢查分類器,快了 5 到 18 倍;Bryo AI 拿它和 Gemini 比商務郵件分類,Gemini 略準,但貴 10 到 20 倍。加上社群在兩週內就做出開源重現,這種檢驗速度是 Watson 的封閉式企業合約從來沒有過的。
但要清楚兩件事:坦白說出證據的侷限,不等於拿出了證據;承諾變窄,也意味著凡是它沒承諾的,責任都落在開發者身上。說到底,這些優點只是讓我們更清楚,該自己去驗證什麼。
結語:每個開發者,都得是自己的 IBM 團隊
回頭看,Jev 和 Watson 最深的相似處,在於它們做決定的方式:先算出一個信心值,再由另一層規則決定要不要相信它。當年 IBM 的團隊為了一場比賽,反覆調校搶答門檻與下注策略,才讓這套機制在節目上運作得恰到好處。
十五年後,Jev 把同樣的機制做成便宜的 API,交到每一位開發者手上。工具變便宜了,調校的工作其實沒有消失:問題怎麼拆解、選項怎麼定義、門檻如何設定、信心值在自己的資料上準不準,這些過去由 IBM 研究團隊負責的事,現在都落在開發者身上。不過好在試錯變便宜了,這件事第一次落在每個開發者都做得到的範圍內。
因此筆者認為,Jev 較好的使用方式不是拿來直接使用,而是依自身需求,調校出適合自己的 Jev。先拿手上真實的資料測試幾次,看看它是否表現理想;再依自己能承受的風險調整門檻,決定哪些事可以放心交給它。
這也回答了前文的問題:開發者為何還要選擇 Jev?其實不該只看發表會上的數據,而該來自你自己的資料。只有在自己的專案裡驗證過,選擇它才有意義。
十五年前,人們看著 IBM Watson,期待它改變世界。這一次,不如先確認它在你的世界裡,是否值得信任。
參考資料
Watson 與 IBM
- Watson Supercomputer Draws to a Tie in First Round of Jeopardy Match(HPCwire,2011)
- IBM's Watson 'Our New Computer Overlord' in 'Jeopardy'(eWeek,2011)
- IBM's Watson Dominates Jeopardy Competition on Day 2(PCWorld,2011)
- IBM bets big on Watson-branded cognitive computing(PCWorld,2014)
- IBM puts aside $1B for new dedicated Watson business(SiliconANGLE,2014)
- IBM invests $1 billion in revolutionary Watson cognitive computing engine(SiliconANGLE,2014)
- Texas hospital struggles to make IBM's Watson cure cancer(PCWorld,2017)
- Watson-based cancer project paused after running aground(Engadget,2017)
- MD Anderson Benches IBM Watson(轉載 Forbes 報導,2017)
- IBM Watson recommended unsafe and incorrect treatments(STAT News,2018)
- Report: IBM Watson delivered 'unsafe and inaccurate' cancer recommendations(MassDevice,2018)
- IBM's Watson recommended 'unsafe and incorrect' treatments(Advisory Board,2018)
- Building Watson: An Overview of the DeepQA Project(AI Magazine,2010)
- Watson's strategies for playing Jeopardy!(Tesauro 等,JAIR)
- David Ferrucci 談 Watson 團隊(NASA APPEL)
Jev 與 TypeSafe AI
- Introducing System One Models & Jev(TypeSafe AI 官網發布文章,2026-09-15)
- A new kind of AI model from a ChatGPT inventor is thrilling developers(TechCrunch,2026-09-18)
- Jev: Warum dieses neuartige KI-Modell gerade Entwickler:innen begeistert(Trending Topics,引述 TechCrunch)
- TypeSafe AI, creadores de Jev, negocian ronda de US$1.000M(Ecosistema Startup,引述 The Information 與 TechCrunch)
- Jev, el modelo no-LLM de un ex-OpenAI, seduce a developers(Ecosistema Startup,引述 TechCrunch)
- Introducing Jev, Ex-OpenAI researchers build a new kind of AI Model(YourStory)
- What Is Jev, and Does It Replace LLMs?
- autotrust/JEV(社群蒸餾重現,非 TypeSafe 官方)
- opendecider-small(社群模型與自建評測,非 TypeSafe 官方)
- TypeSafe AI 開發者資源整理(EveryDev,含 LangChain 等整合)
三.首創技術、企劃雙軌評選!臺灣海洋黑客松競賽盛大舉辦
作者:YD
「臺灣海洋黑客松」於 10 月 10 日至 11 日在國立臺灣海洋大學盛大舉辦,吸引超過 30 支隊伍報名參與。來自不同背景的參賽者齊聚基隆,在兩天的賽程中發揮創意與專業,以科技回應海洋議題,為這片孕育臺灣的藍色國土注入新的想像。
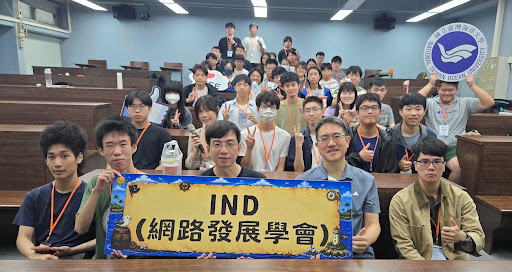
臺灣海洋黑客松競賽
開幕典禮上,指導單位產學營運總中心主任黃章文、資訊工程學系主任馬尚彬親自到場,向全體參賽者致詞勉勵。兩位主任指出,在人工智慧快速發展的時代,許多技術門檻逐漸降低,真正難以被取代的,是發現問題、拆解問題並找出解決方法的能力。他們期許參賽者把握這次機會,不只是寫出能運作的程式,更要深入思考作品背後想解決的問題,培養跨域整合與團隊合作的實力。
總召集人楊光地在分享時則提到,臺灣四面環海,海洋與每個人的生活息息相關,無論是假日出遊、品嚐海鮮,或是認識自己成長的家鄉,大家其實都早已與海洋有所連結。然而,正因為海洋近在身邊,人們往往忽略了它所面臨的挑戰與蘊藏的潛力。他希望透過這次黑客松,讓更多年輕人重新認識海洋,並用自己的專長為海洋發聲。
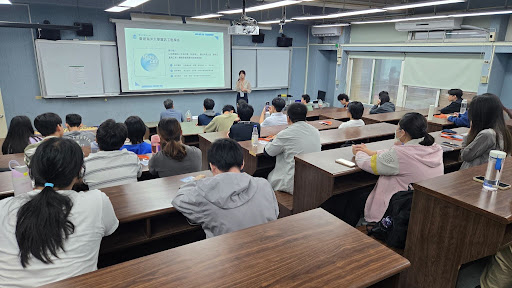 本次競賽以打造與海洋相關的數位作品為目標,形式包含但不限於網站、應用程式及數位遊戲等,題材可涵蓋海洋教育、生態保育、漁業與產業應用、海洋觀光與文化推廣等多元面向,給予參賽者充分的發揮空間。
本屆賽事最大的特色,在於首創「技術」與「企劃」雙軌評選機制。除了檢視作品的技術實作、完成度與創新性之外,各隊伍也須繳交完整的企劃書,內容包含但不限於創作目的、市場規模、財務規劃與行銷策略等。主辦單位表示,一個好的作品不僅要「做得出來」,更要「走得下去」,雙軌評選的設計正是希望引導參賽者從產品思維出發,思考作品如何真正落地、創造價值,甚至具備未來商業化或持續營運的可能。
這樣的機制也讓不同專長的參賽者都能找到發揮舞台:擅長程式開發的成員負責將構想實現,熟悉商業分析與行銷的成員則能為作品規劃清楚的方向與藍圖。主辦單位期盼,藉由技術與企劃並重的訓練,培養兼具實作能力與宏觀視野的跨域人才。
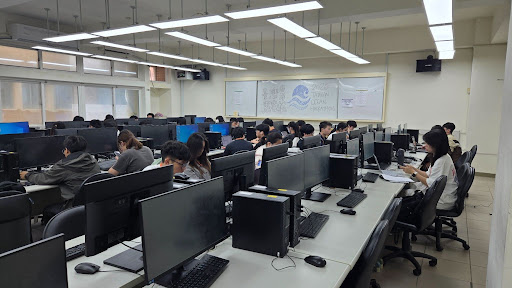
隨著兩天賽程展開,各隊伍將在有限時間內完成發想、開發與簡報,接受評審檢驗。主辦單位也期待,本次黑客松誕生的作品能成為推動海洋永續與數位創新的種子,讓更多人看見臺灣海洋的美好與無限可能。
資料來源: