第三十五期
2026-09-25
一.華為公布昇騰 AI 晶片路線圖
作者:阿棋
華為在Huawei Connect 2026公布新一代昇騰(Ascend)AI晶片與Atlas SuperPoD路線圖,未來將依序推出Ascend 960DT、960PR、970與980。
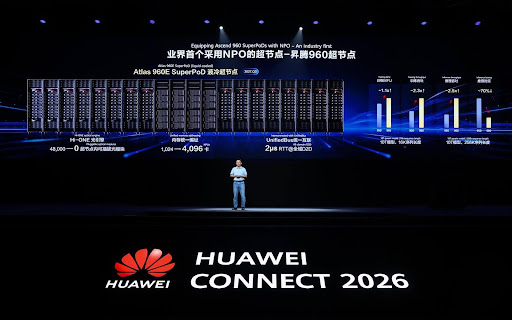
(圖/翻攝自華為直播)
新聞重點
華為在 Huawei Connect 2026 公布新一代昇騰(Ascend)AI 晶片與 Atlas SuperPoD 系統的發展路線。依目前公布規畫,Ascend 960 預計於 2027 年推出,Ascend 970 預計於 2028 年推出,Ascend 980 則規畫在 2029 年登場。 其中,Ascend 980 預計搭載最高 384GB HBM,並提升 AI 運算能力、記憶體頻寬及晶片之間的互連速度。華為也同步發展 Atlas SuperPoD,將大量 AI 加速器整合成大型運算叢集。
華為為什麼投入 AI 晶片
華為原本以電信設備、手機與企業 ICT 服務聞名,近年則把 AI 算力視為下一階段基礎建設。昇騰系列是華為面向 AI 訓練與推論的加速器產品,搭配鯤鵬處理器、Atlas 伺服器、華為雲與軟體工具,形成從硬體到雲端服務的完整方案。
在高階 AI 晶片取得受到限制的背景下,華為必須同時處理兩個問題:一方面提升單顆晶片的效能,另一方面讓更多晶片能夠高速互連、共同工作。這也是華為強調超節點與超大規模叢集的原因。
從單顆晶片到超節點
一般 AI 伺服器會將多張加速卡放在同一台或同一個機櫃中;超節點則進一步把大量 NPU、記憶體與網路連接成一個更緊密的運算單位。對大型語言模型而言,這能減少晶片互相傳送資料時的等待時間,讓訓練與推論更有效率。 華為公布的 Atlas 960E SuperPoD 預計採用液冷與近封裝光學技術,最多可整合 4096 顆 NPU。華為表示,該系統可支援十兆參數規模的模型工作負載,但這些數據屬於華為公布的測試或規畫結果,仍需等待實際產品與第三方測試驗證。
為什麼重要
這項消息顯示,華為的目標不只是開發單一 AI 晶片,而是建立涵蓋晶片、記憶體、先進封裝、液冷散熱、互連網路、伺服器與儲存系統的完整 AI 基礎建設。
-
AI加速器晶片
-
HBM 高頻寬記憶體
-
晶片互連與高速網路
-
AI 伺服器與大型運算叢集
-
模型訓練與推論平台
目前面臨的挑戰
不過,華為公布的數據屬於產品規畫與預估規格,Ascend 980 在正式推出前仍可能調整。華為接下來能否大量生產、取得足夠的高頻寬記憶體,並建立能與 NVIDIA CUDA 生態系競爭的軟體環境,仍需要持續觀察。
此外,華為輪值董事長徐直軍表示,中國目前的 AI 運算設備仍供不應求,代表市場需求很大,但供應能力仍是重要限制。
AI Agent 與安全議題
華為也把 AI Agent 視為下一階段的重要應用。與只回答問題的聊天機器人相比,AI Agent 可能會自行規畫步驟、呼叫工具、讀取資料,甚至操作外部系統,因此對算力、網路與安全控制的要求更高。
徐直軍指出,中國 AI 模型目前可能還沒有發展到足以感受到美國頂尖 AI 公司所警告的全部風險,但華為認為產業仍需要在模型能力與風險管理之間取得平衡。這代表華為的 AI 戰略不只包括晶片,也包括 Agent 的安全、隱私與治理。
華為與 NVIDIA 的差距應如何看待
目前不宜只用單一 PFLOPS 數字判斷華為是否已經超越 NVIDIA。AI 系統的實際表現還會受到軟體工具鏈、模型最佳化、記憶體容量、互連效率、功耗、供貨數量與客戶部署經驗影響。
比較合理的觀察是:華為正在透過增加叢集規模、改進互連架構與整合軟硬體,建立一條不完全依賴外部高階 GPU 的路線。這條路線能否在大規模商用環境穩定運作,才是後續真正的關鍵。
華為的發展方向反映出 AI 產業競爭已經從「誰的模型比較強」,逐漸轉向「誰能提供完整且穩定的 AI 運算系統」。未來除了晶片效能之外,記憶體、封裝、散熱、網路、軟體與量產能力,都會影響華為能否縮小與國際 AI 晶片大廠的差距。
資料來源
科技島:華為公布昇騰 AI 晶片新路線圖 960系列2027登場、980 HBM容量上看384GB
https://www.technice.com.tw/issues/semicon/295623/
科技島:中國AI還沒強到感受到「失控風險」 華為徐直軍:應加快模型發展
https://www.technice.com.tw/issues/ai/295570/
華為官方:華為發布全球首個采用NPO的超節點——昇騰960超節點
https://www.huawei.com/cn/news/2026/9/hc-ascend960-supernode
二.自動門怎麼知道我來了?從程式碼到物理動作,認識微控制器「MCU」
作者:昀
電機領域對我來說最吸引人的時刻,莫過於在電腦裡一行行撰寫的程式碼,能夠真實地在現實世界裡產生物理操作。
有些非工程背景的朋友會誤以為,平常見到會「自動」運作的機器,裡面一定裝了類似電腦 CPU 的運算大腦。但其實我們日常接觸到的超商自動門、汽機車裡的 ABS 防鎖死煞車系統,它們的核心大多是「微控制器(MCU,Microcontroller Unit)」。
微控制器與 CPU 的差異:對「即時性」的追求
為什麼我們不使用效能強大的 CPU,而是選擇 MCU 呢?這牽涉到硬體與嵌入式系統中最核心的概念:「即時性(Real-time)」。
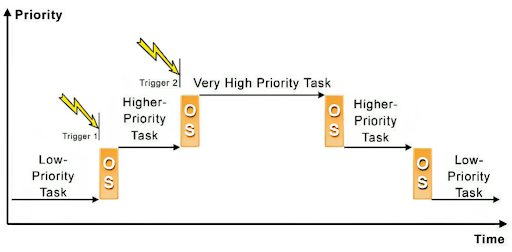
圖 1:Real-time 來源:Real-time operating system, RTOS初探
CPU 就像是大型企業的 CEO,雖然運算能力極強,但通常需要跑龐大的作業系統(如 Windows)。作業系統會同時管理大量背景程式,當感測器訊號傳遞進來時,CPU 可能剛好在處理其他資料,導致反應時間晚了幾毫秒。單純處理資料或跑程式碼或許感受不出差別,但在汽機車的 ABS 系統裡,這極小的時間差,可能就是存活與死亡的差距。
系統架構:裸機運行 (Bare-metal) 的優勢
相反地,MCU 把運算核心、記憶體以及各種溝通介面,全部微縮整合進一顆小晶片裡。
它不跑龐大且會拖慢速度的作業系統,通常是採取「裸機運行(Bare-metal)」或是運行極度輕量的「即時作業系統(RTOS)」。它不處理豐富的圖形介面,唯一的任務就是死死盯著 Pin 腳。一旦接收到訊號,它必定能在規定時間的「微秒」等級內做出反應,這種說到做到的特性,就是工程師最看重的即時性。
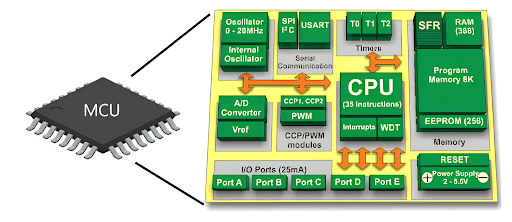
圖 2:MCU 內部結構圖 來源:MCU Market Insight
軟硬體溝通機制:從輪詢 (Polling) 到中斷 (Interrupt)
在撰寫 MCU 程式碼時,我們是如何與現實硬體溝通的呢?靠的就是晶片邊緣那一根根的金屬接腳,我們稱為「通用輸入輸出腳位 GPIO(General-Purpose Input/Output)」。
以自動門為例,如果我們在程式裡讓 MCU 每秒鐘去問感測器幾千次「有人來了嗎?」(這種作法稱為輪詢 Polling),會極度浪費運算資源。
實務上,我們會利用硬體層級的「中斷機制(Interrupt)」。我們把感測器連接到特定的 GPIO 上,並在程式中設定:平時 MCU 可以進入休眠或處理其他背景資料;但只要感測器偵測到人體紅外線,就會立即發出電壓變化。
這個電壓變化就如同緊急警報一般,會「中斷 Interrupt」MCU 當下的任何動作,強制它立即跳去執行「驅動馬達開啟」的程式碼。執行完成後,再回歸原本的狀態。這就是系統能極度省電,卻又異常靈敏的關鍵秘密。
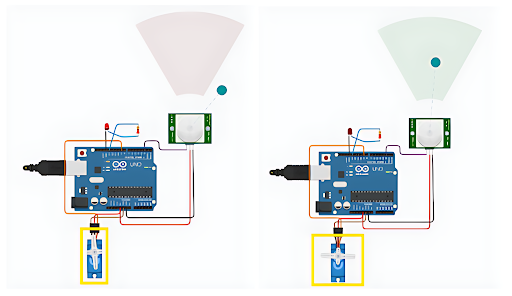
圖3:自動門中斷機制概念(使用Tinkercad模擬)。左圖為待機狀態;右圖為紅外線感測觸發「中斷 Interrupt」後,MCU立即驅動馬達轉動90度執行開門動作。
AI 時代下:無可取代的底層思維
當我們把目光放在酷炫的 AI 模型與雲端運算時,往往會忽略這些真正在前線作戰的微控制器。這次我們從基礎的 GPIO 數位控制出發,之後會跟大家聊到 ADC,再到現在越來越普及的 Edge AI。每一次的技術迭代,其實都建立在這些實打實的硬體基礎上。
在這個軟體框架越來越高階的時代,能夠打開 Datasheet、看懂硬體暫存器,並且親手撰寫程式去操控實體電壓變化的底層開發能力,依然是電機工程體系中最硬核,也是最無可取代的浪漫。
資料來源:
Embedded Software Engineering 101: Microcontroller Basics
Bare metal vs RTOS: How to choose the right approach for an embedded system project
Real-time operating system, RTOS初探-圖1
(註:本文內容與 Tinkercad 模擬皆為本人親自實作撰寫,僅以 AI 輔助語句潤飾。)
.DFS 與 BFS 簡介
作者:游錐
今天你朋友在百貨公司裡面走丟了,假設他都站在原地不動,而且兩個人都在同一樓層的話,要怎麼樣才可以最快找到他呢?
如果這間百貨公司很小,直接每個地方走過去找就好了。但如果它有很多走道,而且每個地方又會分成好幾條路,就會開始出現一個問題:
到底要按照什麼順序找?
我們可以先想一個很直覺的方法。
DFS 深度優先搜尋
如果你選擇了一條路,不把它走到底確認你朋友真的不在,就跑去走其他的路,那你其實很難確定自己到底有沒有找過完整。
所以最簡單的方法就是:
選一條路,先一直走下去。
遇到岔路就選一條繼續走,直到最後發現這條路已經沒有地方可以去了,才回到上一個岔路口,再換另一條路。
大概會像這樣:
        ┌── A ── A1 ── A2

        │

你 ─────┼── B

        │

        └── C
如果現在選了 A,就先一路往 A、A1、A2 找。
如果 A2 已經沒有其他地方可以走了,就回到 A1,再看看有沒有其他還沒找過的方向。
這種「先往一個方向深入,走不下去再回來」的方法,就是 DFS(Depth-First Search,深度優先搜尋)。
我覺得 DFS 最好理解的地方其實就是「走迷宮」。
你不需要一開始就知道整座迷宮長什麼樣子,只要記得自己從哪裡走過來,走到死路時再退回去就可以繼續找。
BFS 廣度優先搜尋
不過,回到一開始的問題。
如果目標真的是最快找到朋友,一直往某一條路走到底好像不一定是個好方法。
因為朋友可能根本就在你旁邊。
這時候可以換一種找法:
不要先走很遠,而是先把附近全部找一遍。
假設你現在在百貨公司的中間,可以走到四個地方。
那就先把這四個地方找完。
接著,再從這四個地方繼續往外找。
於是搜尋的範圍會慢慢變成:
        第 3 層

     ┌─────────┐

       第 2 層

     ┌───────┐

       第 1 層

        你
也就是:
先找距離自己一步的地方,再找兩步的地方,再找三步的地方。
這就是 BFS(Breadth-First Search,廣度優先搜尋)。
它不像 DFS 一樣一直沿著一條路往裡面走,而是先把同一個距離範圍內的地方處理完,再繼續往外擴張。
為什麼 BFS 可以找最短路徑?
這也是 BFS 很常被拿來使用的原因。
假設百貨公司裡每走一段路都算一步,我們想找到朋友,而且希望走最少步。
BFS 會先找「一步可以到的地方」。
如果沒找到,就找「兩步可以到的地方」。
再沒找到,就找「三步可以到的地方」。
所以只要每一步的成本都一樣,BFS 第一次找到朋友的時候,就代表我們已經用最少的步數到達他的位置。
這個概念其實不只可以拿來找人。
例如遊戲裡角色要走到某個位置、迷宮裡找出口、地圖上找最短移動距離,甚至是社群網站裡找「朋友的朋友」,都可以用類似的方式想。
那 DFS 不就沒用了?
一開始看到這裡,我也很容易把它想成:
BFS 可以找最短路徑,那是不是 BFS 比 DFS 好?
其實不是。
兩個方法只是找東西的順序不同。
如果今天不是要找最近的地方,而是要把所有可能性都試過一次,DFS 反而會很好用。
例如你在解一個迷宮,不只是想知道「有沒有出口」,而是想把所有可能的走法都找出來。
這時候就可以先選一條路一直走,走不通就回來換下一條。
這種「嘗試 → 走不通 → 回頭 → 再嘗試」的過程,本身就是 DFS 很重要的用途。
其實我們一直都在做同一件事
看到這裡可以發現,不管是 DFS 還是 BFS,我們其實都在做同一件事:
從目前的位置開始,把可以到達的地方一個一個找出來。
只是 DFS 選擇:
「先把這條路走深一點。」
而 BFS 選擇:
「先把離我近的地方找完。」
如果把百貨公司換成電腦科學裡的「圖(Graph)」,每個位置就可以看成一個節點,而可以互相走到的地方就是節點之間的連線。
這樣一來,原本只是「在百貨公司找朋友」的問題,就變成了:
從一個節點開始,要按照什麼順序探索其他節點?
DFS 和 BFS 就是兩種最基本的答案。
結語
DFS 和 BFS 其實沒有想像中複雜。
如果你想像自己真的在一個陌生的地方找人:
DFS 就是選一條路一直走,走到底再回頭。
BFS 則是先把附近找完,再慢慢往外擴張。
我自己覺得這兩個方法最重要的地方,不是背下它們的名字,而是開始習慣去想:
「如果我不知道答案在哪裡,我要按照什麼順序把可能的地方找完?」
當問題變成迷宮、遊戲地圖、社群關係或其他更複雜的結構時,這個想法還是可以繼續用。
而 DFS 和 BFS,就是學習這種搜尋方式最基本的兩個起點。